--
ParallelFold 集群使用方法
ParallelFold 是面向蛋白质结构预测的并行计算工具,集成了 AlphaFold 的单体和多聚体预测流程,并根据输入序列组织计算任务。智算平台已将 ParallelFold 封装为 CHESS 应用,用户只需准备 FASTA 文件、选择预测类型和输出目录,即可提交 GPU 作业。
项目信息
ParallelFold 由上海交通大学团队开发。项目源码和技术说明可参考 ParallelFold GitHub 仓库。
使用前准备
登录 CHESS 平台
访问 CHESS 平台并使用本人账号登录:
https://webhpc.tibhpc.net/#/login
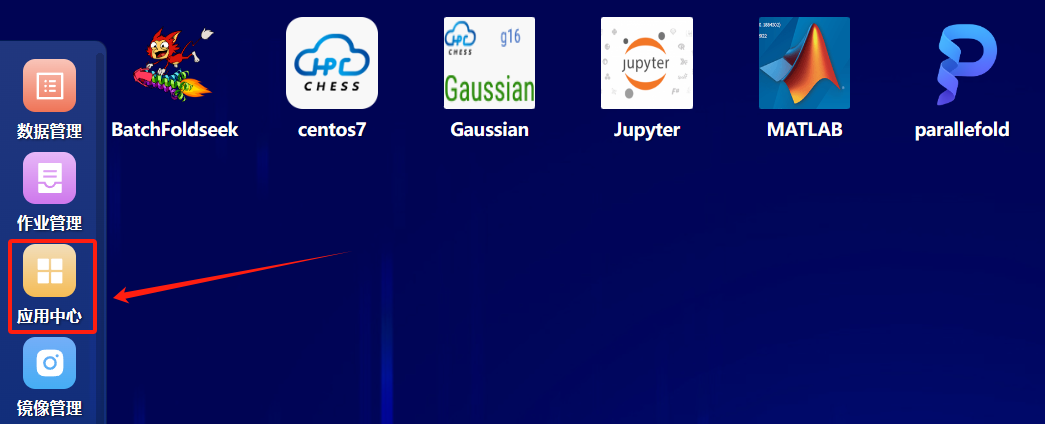
登录后,点击左侧“应用中心”。
准备 FASTA 文件
先将 FASTA 文件上传到本人集群目录,例如:
text
/hpcfs/fhome/用户名/parallelfold/input/sample.fastaFASTA 文件中的每条序列都需要有以 > 开头的唯一标识。例如:
text
>protein_A
MKTAYIAKQRQISFVKSHFSRQDILDLWQ
>protein_B
MSEQNNTEMTFQIQRIYTKDISFEAPNAPH同时准备一个独立的结果输出目录:
text
/hpcfs/fhome/用户名/parallelfold/output/请确认当前账号对 FASTA 文件有读取权限,并对输出目录有写入权限。
下载并打开应用
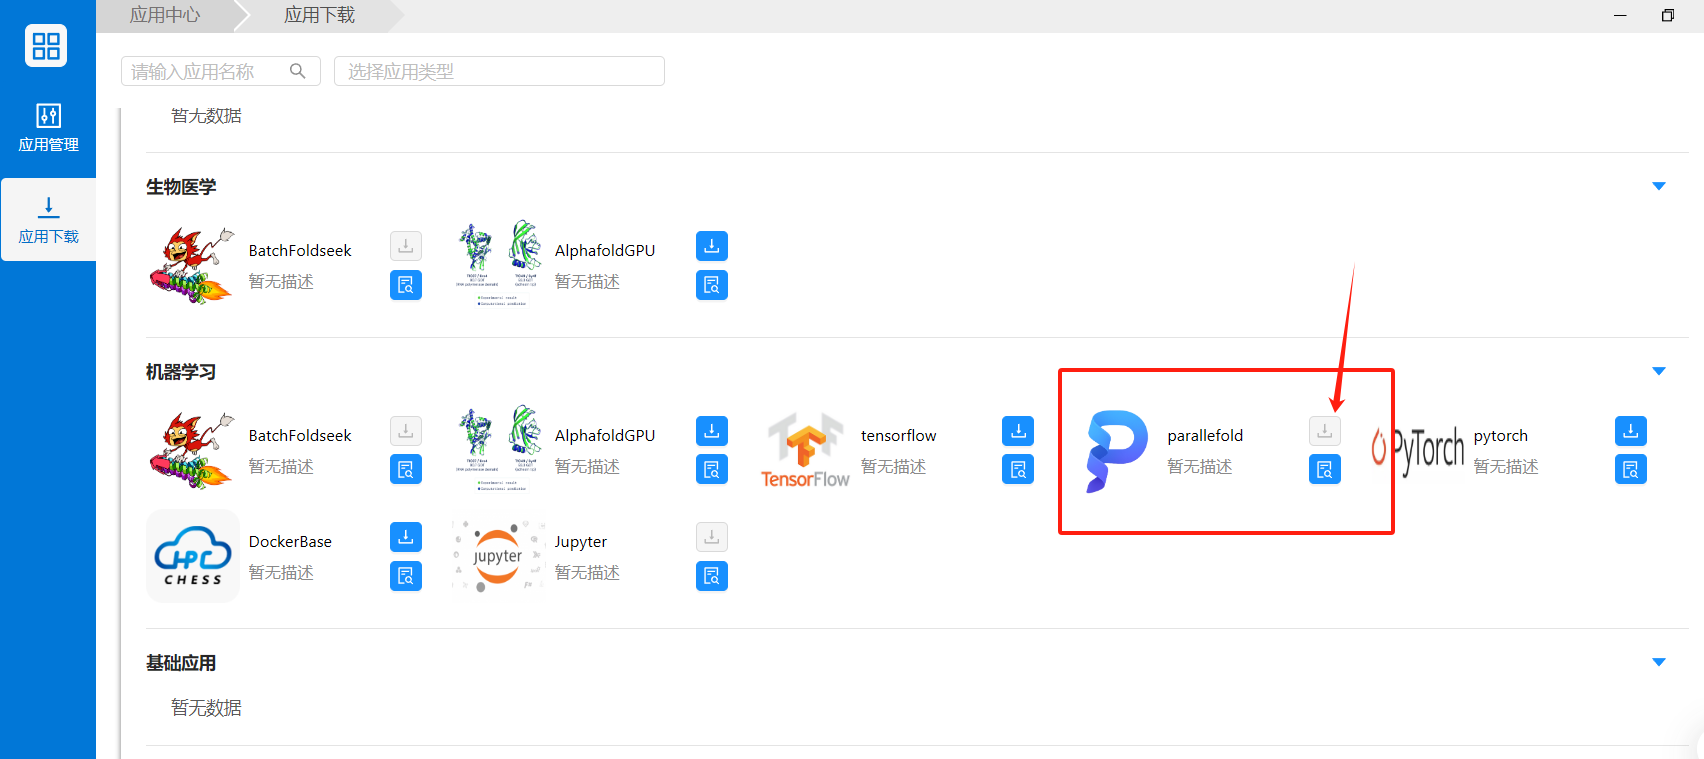
在“应用下载”页面的“机器学习”分类中找到界面名称为 parallefold 的应用,点击下载按钮,将它添加到 CHESS 桌面。
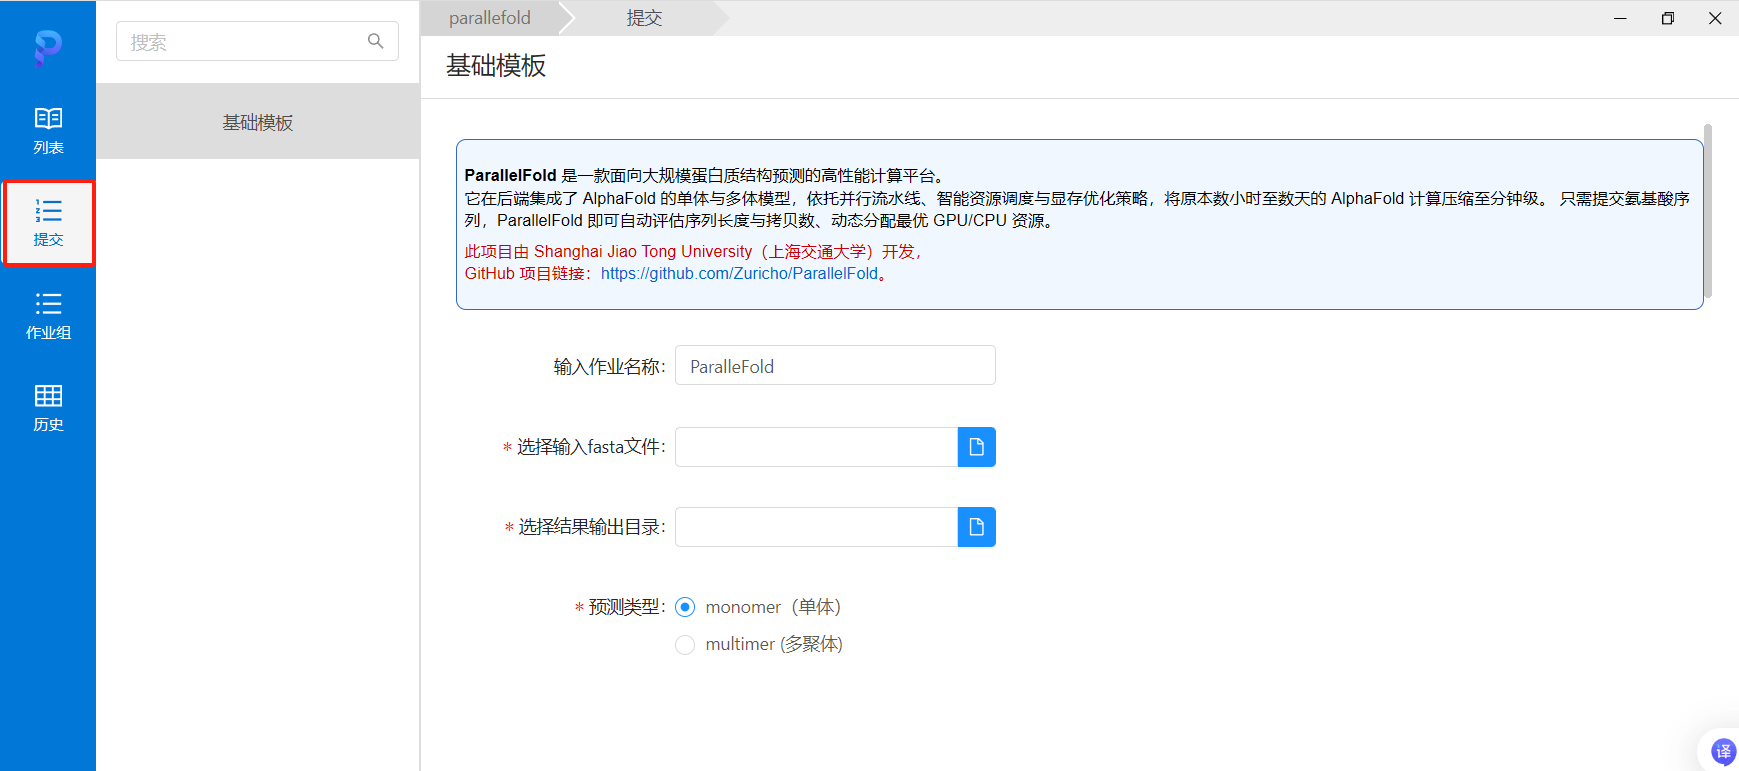
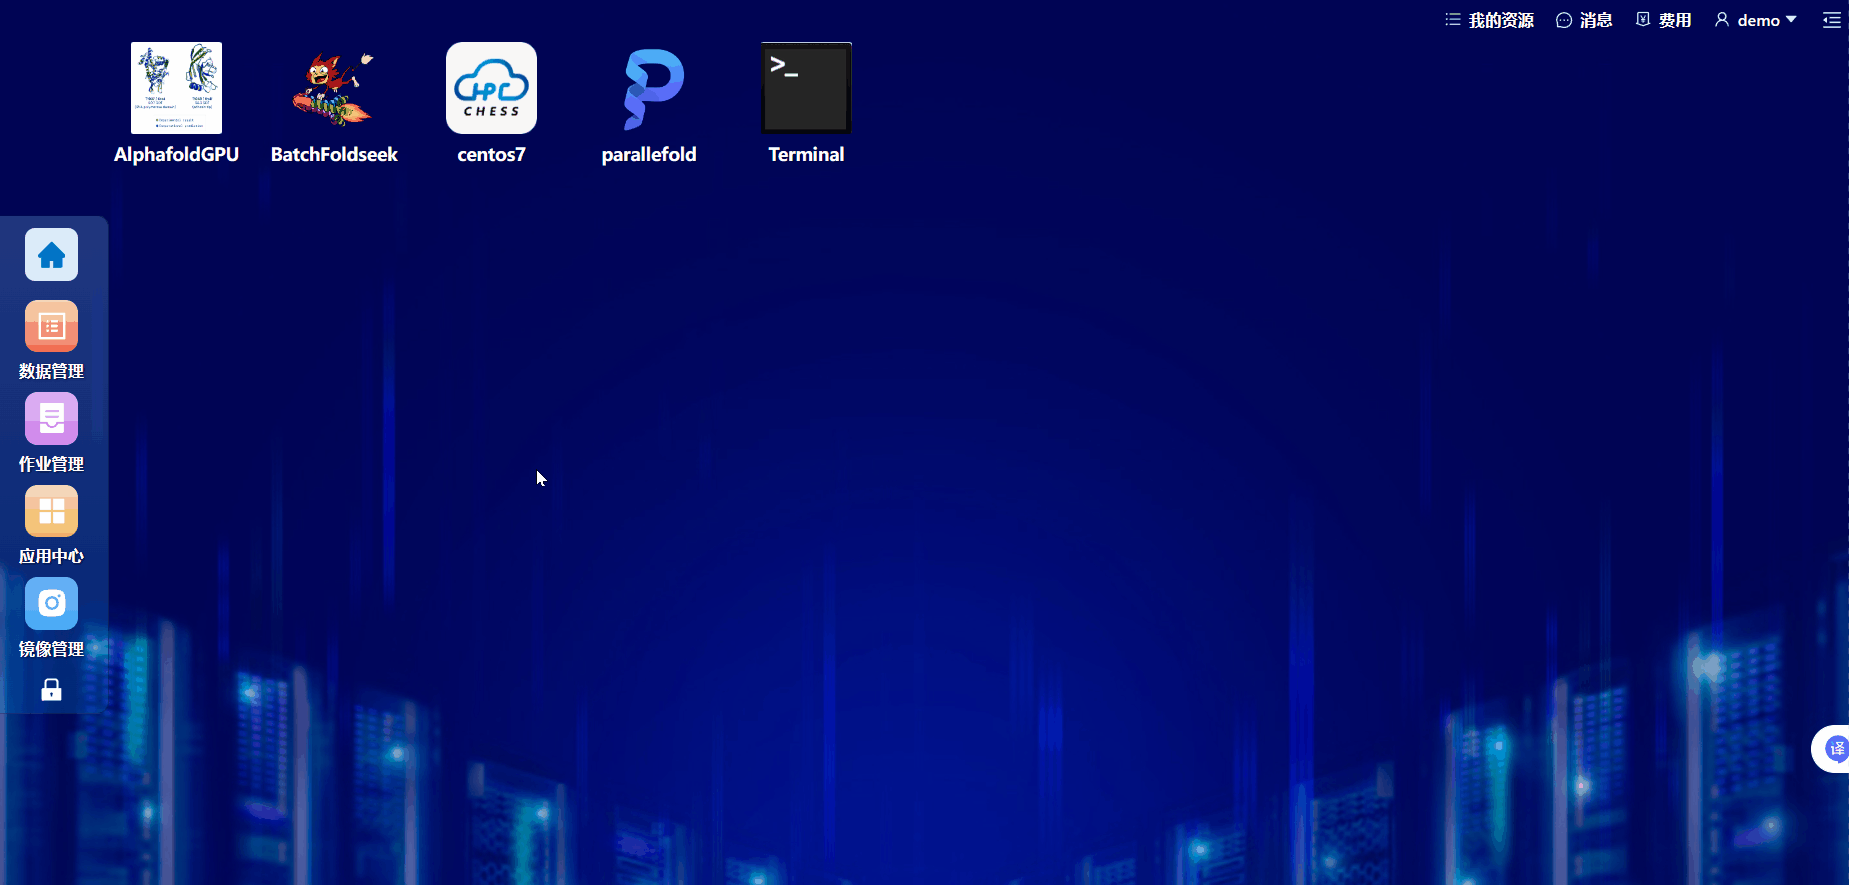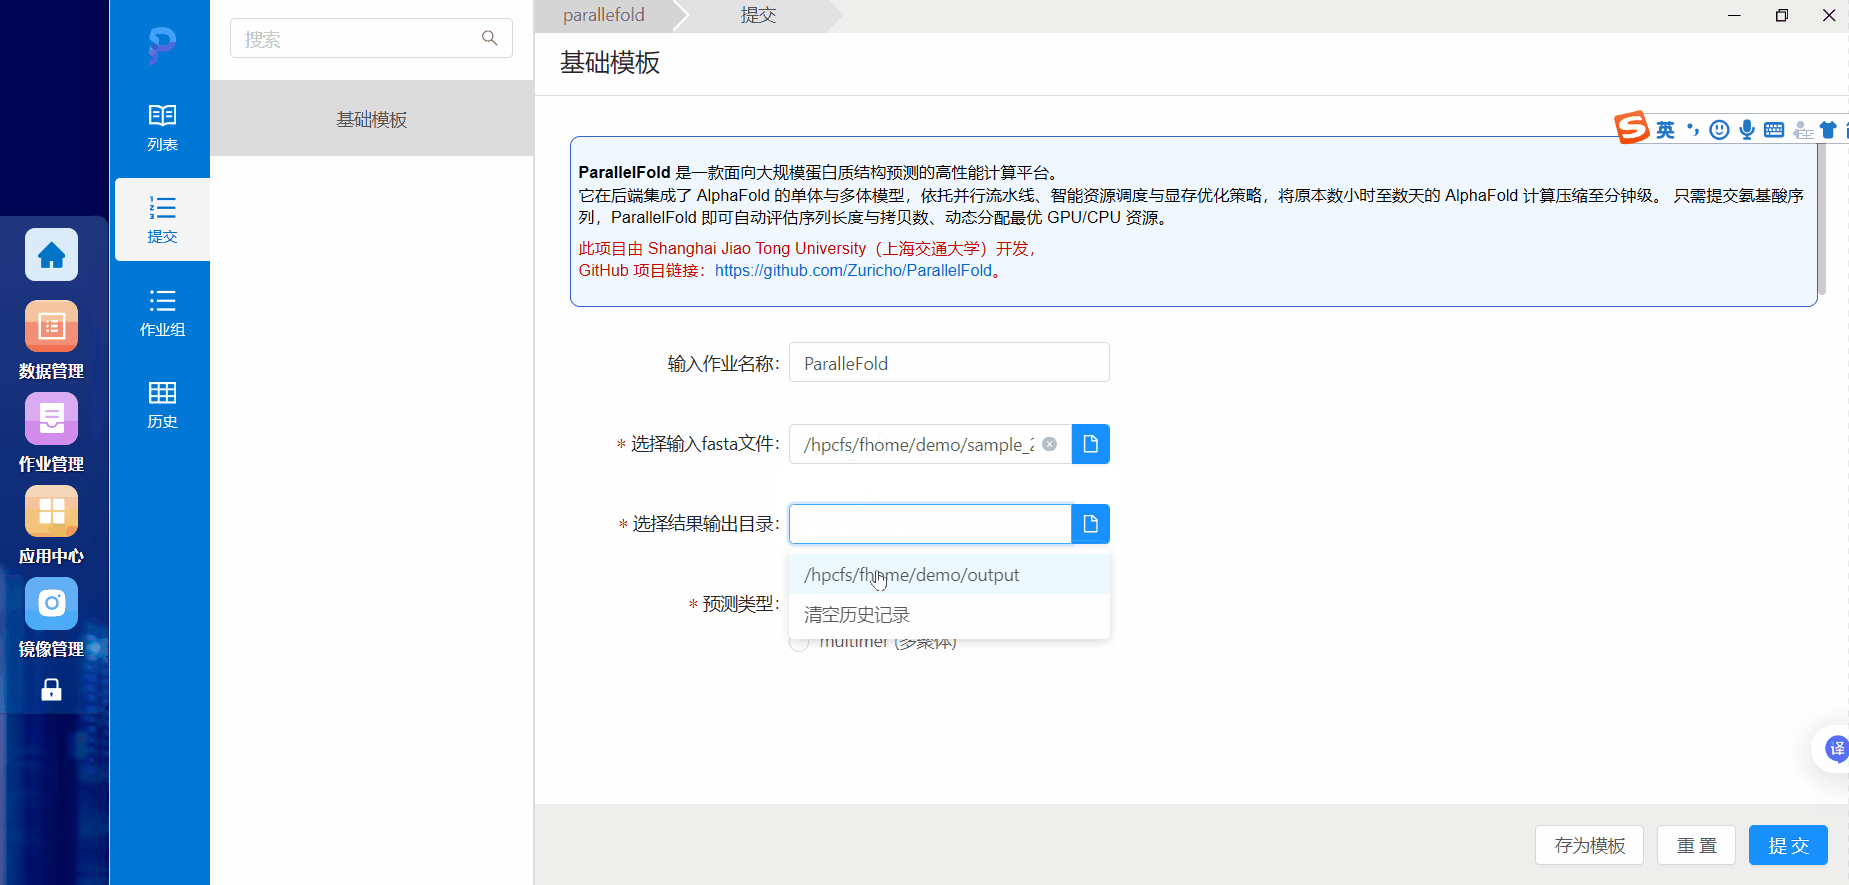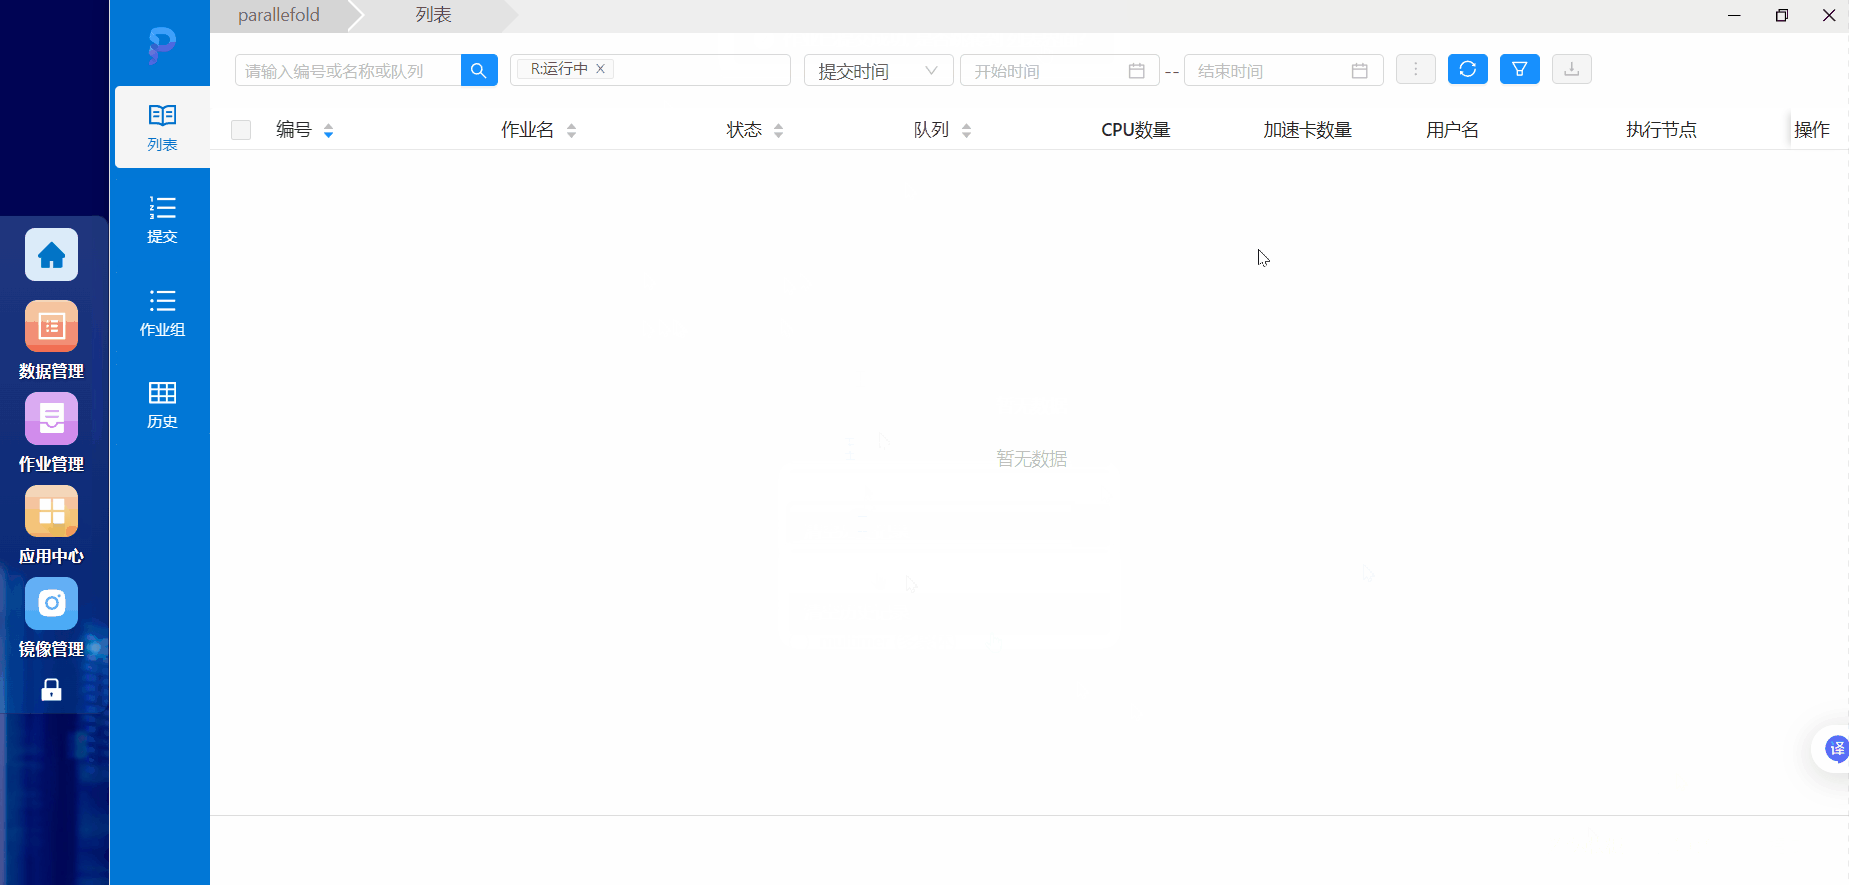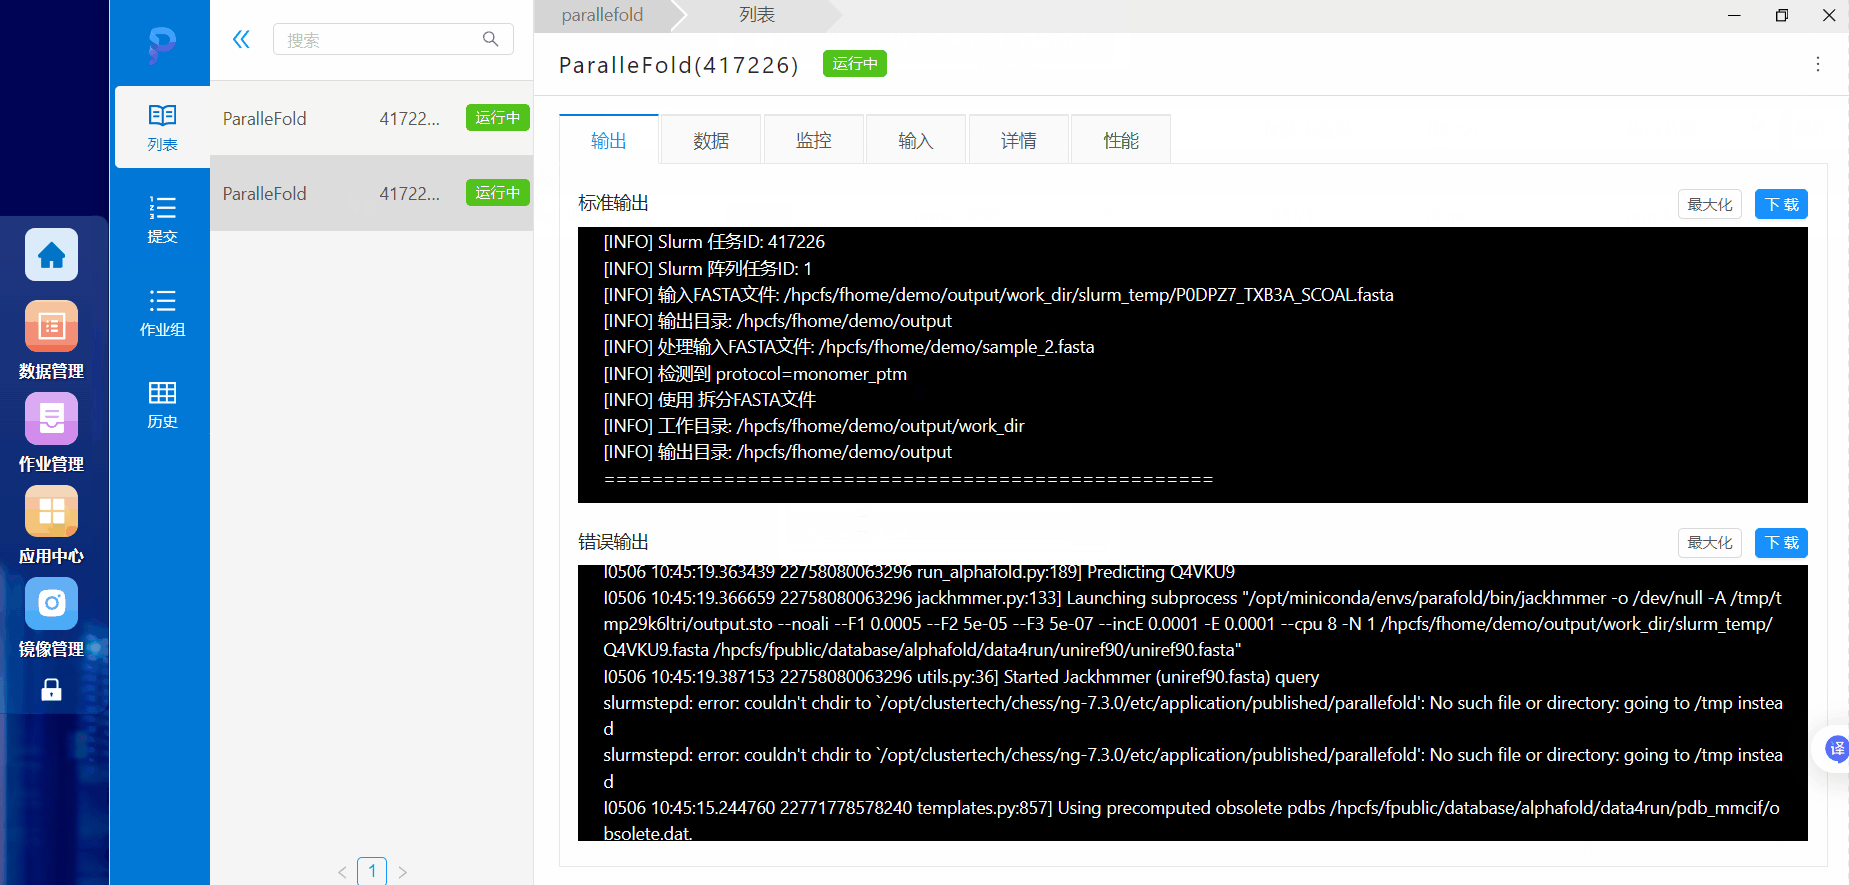
返回桌面并打开 parallefold 应用,然后点击左侧“提交”进入任务配置页面。
填写任务参数
| 参数 | 说明 |
|---|---|
| 作业名称 | 用于区分本次预测任务,建议填写简短且有意义的名称 |
| 输入 FASTA 文件 | 已上传到集群的 FASTA 文件完整路径 |
| 结果输出目录 | 保存结构预测结果的集群目录 |
| 预测类型 | 根据输入内容选择 monomer(单体)或 multimer(多聚体) |
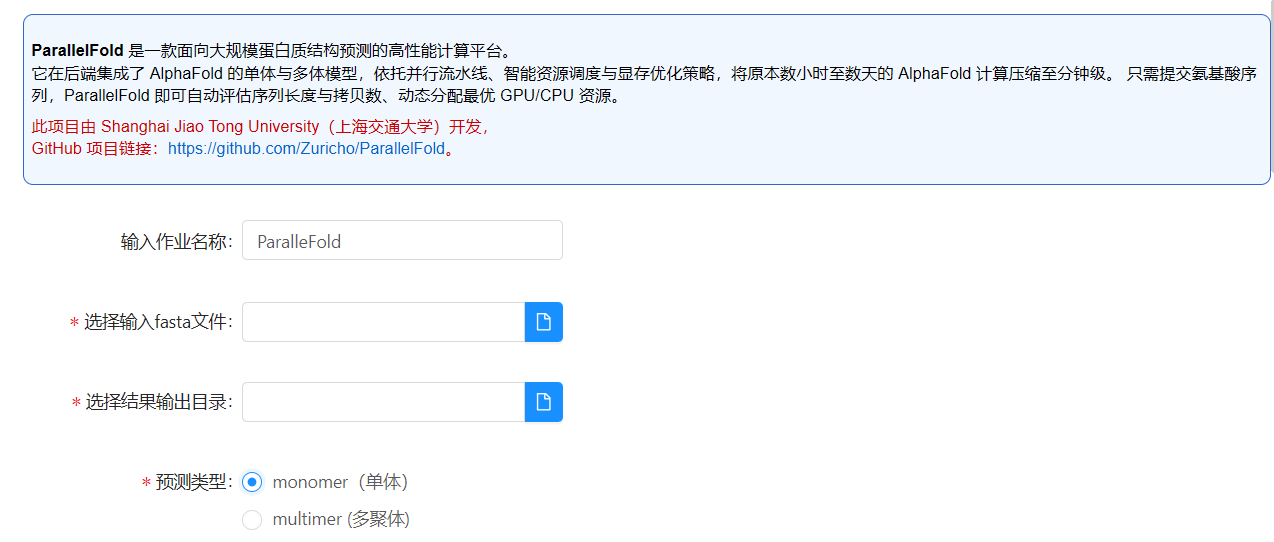
单体预测(monomer)
选择 monomer 时,应用会把输入 FASTA 中的每条序列分别提取为独立的 .fasta 文件,并生成 fasta_id_map.txt 记录序列 ID 与任务之间的对应关系。该模式适合批量预测多个互不相关的单链蛋白。
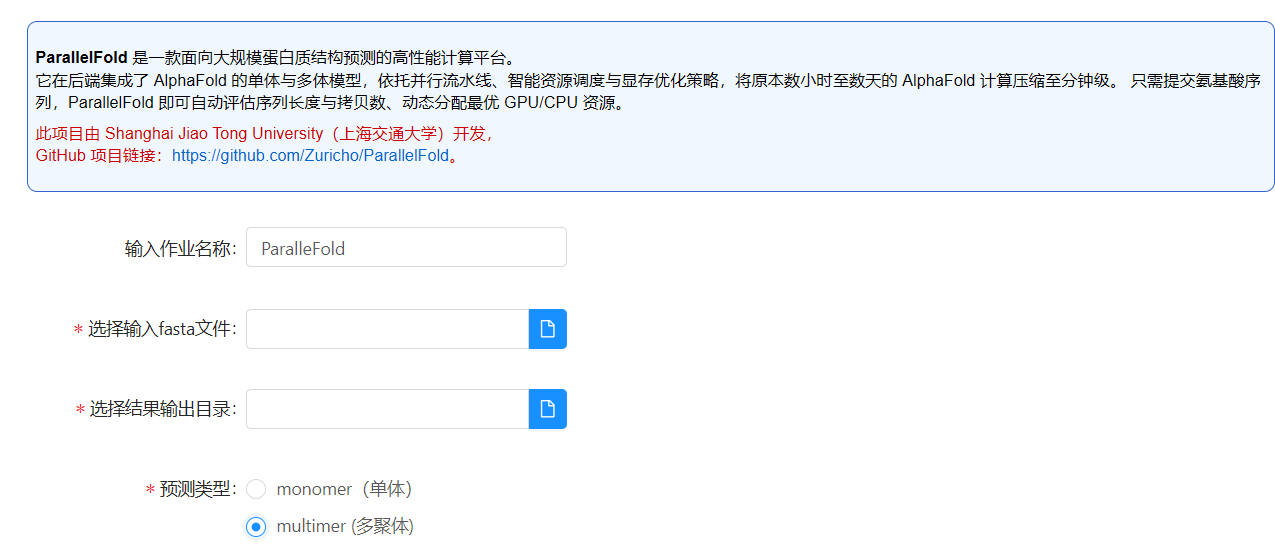
多聚体预测(multimer)
选择 multimer 时,输入 FASTA 中的所有序列会作为同一个复合物整体处理。应用会生成 multimer_input.fasta,并在 fasta_id_map.txt 中记录映射关系。该模式适合预测多个蛋白链组成的复合物。
正确选择预测类型
如果 FASTA 中包含多条需要分别预测的独立序列,请选择 monomer;只有这些序列需要共同组成一个复合物时,才选择 multimer。预测类型选错会改变任务拆分方式和结果含义。
确认 FASTA 文件、输出目录和预测类型后提交任务。
查看作业状态和日志
提交成功后,可以在应用左侧的“列表”或“作业组”中查看编号、作业名、状态、队列、CPU 数量、GPU 数量和执行节点。
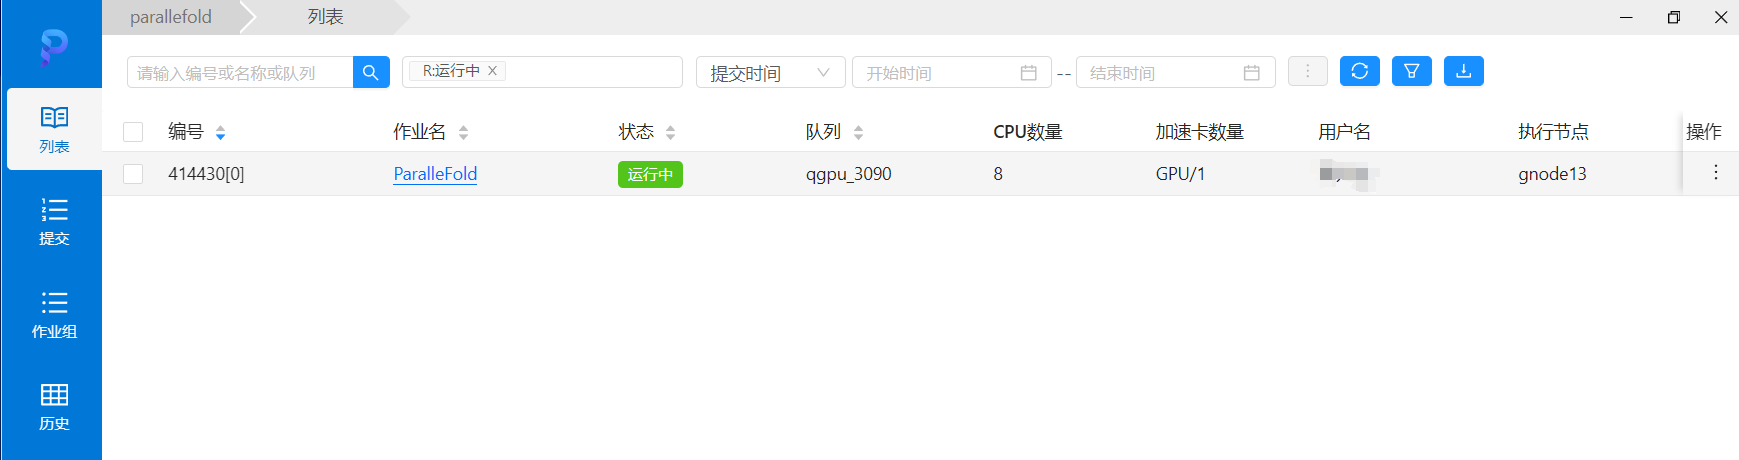
当前 CHESS 模板会将任务提交到 qgpu_3090 队列,并为每个任务分配 1 张 GPU。资源繁忙时,作业可能先处于排队状态。
点击作业名称可以进入详情页,查看以下信息:
- “输出”:标准输出和错误输出
- “监控”:运行过程中的资源使用情况
- “输入”:本次任务提交的参数
- “详情”:队列、节点和作业 ID 等信息
- “性能”:作业性能与资源利用情况
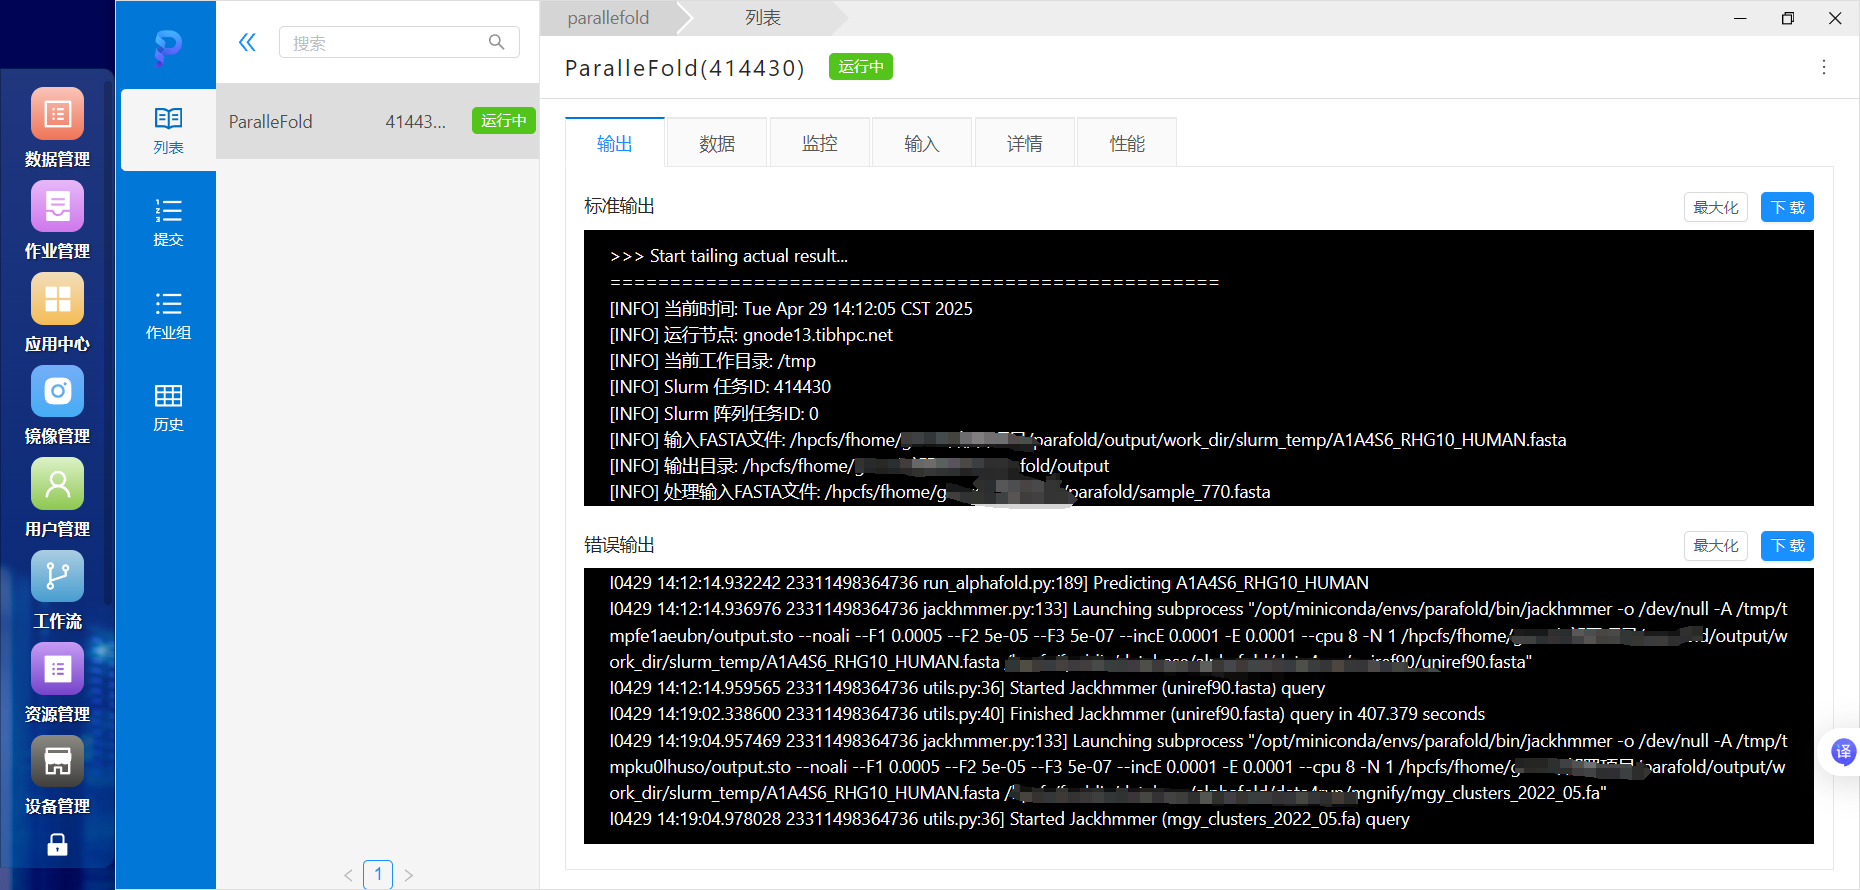
如果任务失败,请优先检查“错误输出”末尾的报错信息。
完整操作录屏:
查看预测结果
任务完成后,结构预测结果会写入提交时指定的输出目录。每个预测对象通常有一个独立的结果子目录。

常见结果文件包括:
| 文件 | 说明 |
|---|---|
ranked_*.pdb | 按模型置信度排序的预测结构,ranked_0.pdb 通常为排名最高的结构 |
relaxed_model_*.pdb | 经过结构松弛处理的模型 |
unrelaxed_model_*.pdb | 未经过结构松弛处理的模型 |
ranking_debug.json | 模型排序和评分信息 |
result_model_*.pkl | 各模型的完整预测结果数据 |
features.pkl | 预处理后供模型使用的输入特征 |
timings.json | 各阶段运行时间 |
msas/ | 多序列比对相关文件 |
应用还会在工作目录中保存序列映射、Slurm 脚本和运行日志:

常见内容包括:
fasta_id_map.txt:输入序列与任务 ID 的映射关系parallelfold_array_job_monomer_ptm.slurm:单体预测的 Slurm 数组作业脚本parallelfold_array_job_multimer.slurm:多聚体预测的 Slurm 数组作业脚本slurm_logs/:Slurm 作业日志slurm_temp/:任务运行期间生成的临时文件
常见问题
无法选择 FASTA 文件
确认文件已上传到集群目录,并且扩展名为 .fasta、.fa 或平台支持的 FASTA 格式。路径必须是集群路径,不能填写本地电脑路径。
提交后一直排队
ParallelFold 使用 GPU 队列。队列资源紧张时任务会等待,可以在作业列表中查看状态,无需重复提交相同任务。
多条序列只生成了一个复合物结果
检查是否误选了 multimer。如果每条序列需要独立预测,应选择 monomer 后重新提交。
结果目录为空或任务失败
在作业详情中检查标准输出和错误输出,并确认 FASTA 格式正确、输出目录可写。还可以查看工作目录中的 slurm_logs/ 获取各子任务日志。
不同任务的结果混在一起
建议每次提交时使用独立输出目录,例如:
text
/hpcfs/fhome/用户名/parallelfold/output/20260907_test/