--
OpenMPI 集群使用方法
OpenMPI 是开源的消息传递接口(MPI)实现,适合在多个进程或多个计算节点之间进行并行计算。平台提供 GCC、OpenMPI 和 Slurm 调度环境,用户可以编译 MPI 程序并通过计算队列运行。
本文使用一个 MPI 与 OpenMP 混合并行的圆周率计算程序,演示源码编译、资源申请、作业提交和结果检查的完整流程。
不要在登录节点直接运行并行任务
登录节点仅用于编辑源码、准备脚本和进行短时间检查。正式计算必须通过 Slurm 提交到计算队列。
示例文件
平台公共示例位于:
text
/hpcfs/fpublic/script_example/openmpitest/可以将示例复制到本人家目录后再修改:
bash
cp -r /hpcfs/fpublic/script_example/openmpitest ~/openmpitest
cd ~/openmpitest也可以创建新的工作目录,并按下文新建源码和作业脚本:
bash
mkdir -p ~/openmpitest
cd ~/openmpitest编写测试程序
将下面内容保存为 openmpitest.c:
c
#include <mpi.h>
#include <omp.h>
#include <stdio.h>

int main(int argc, char *argv[])
{
    const long int n = 10000000;
    int rank, size;

    MPI_Init(&argc, &argv);
    MPI_Comm_rank(MPI_COMM_WORLD, &rank);
    MPI_Comm_size(MPI_COMM_WORLD, &size);

    const long int base = n / size;
    const long int remainder = n % size;
    const long int local_n = base + (rank < remainder ? 1 : 0);
    const long int first = rank * base + (rank < remainder ? rank : remainder);
    const long int last = first + local_n;
    const double h = 1.0 / (double)n;
    double local_pi = 0.0;
    double pi = 0.0;

#pragma omp parallel for reduction(+ : local_pi)
    for (long int i = first; i < last; ++i) {
        const double x = (i + 0.5) * h;
        local_pi += 4.0 / (1.0 + x * x);
    }

    MPI_Reduce(&local_pi, &pi, 1, MPI_DOUBLE, MPI_SUM, 0,
               MPI_COMM_WORLD);

    if (rank == 0) {
        printf("MPI processes: %d, OpenMP threads/process: %d\n",
               size, omp_get_max_threads());
        printf("Approximation of pi: %.13f\n", pi * h);
    }

    MPI_Finalize();
    return 0;
}程序首先将积分区间分配给多个 MPI 进程,再由每个进程中的 OpenMP 线程并行计算,最后通过 MPI_Reduce 汇总结果。
编写 Slurm 作业脚本
将下面内容保存为 openmpitest.slurm:
bash
#!/bin/bash
#SBATCH --job-name=openmpitest
#SBATCH --partition=qcpu_18i
#SBATCH --nodes=2
#SBATCH --ntasks=4
#SBATCH --ntasks-per-node=2
#SBATCH --cpus-per-task=8
#SBATCH --mem=32G
#SBATCH --time=00:10:00
#SBATCH --output=%x-%j.out
#SBATCH --error=%x-%j.err

set -euo pipefail

module purge
module load gcc
module load mpi/openmpi-4.1.6

export OMP_NUM_THREADS="${SLURM_CPUS_PER_TASK}"
export OMP_PLACES=cores
export OMP_PROC_BIND=close

mpicc -O3 -fopenmp openmpitest.c -o openmpitest
mpirun -np "${SLURM_NTASKS}" ./openmpitest资源参数说明
| 参数 | 本示例配置 | 说明 |
|---|---|---|
--nodes | 2 | 使用 2 个计算节点 |
--ntasks | 4 | 共启动 4 个 MPI 进程 |
--ntasks-per-node | 2 | 每个节点运行 2 个 MPI 进程 |
--cpus-per-task | 8 | 每个 MPI 进程使用 8 个 OpenMP 线程 |
--mem | 32G | 每个节点申请 32 GB 内存 |
本示例每个节点共使用 2 × 8 = 16 个 CPU 核。修改 MPI 进程数或 OpenMP 线程数时,必须同步调整 Slurm 参数,避免实际使用的 CPU 核数超过申请量。
纯 MPI 程序
如果程序没有使用 OpenMP,可将 --cpus-per-task 设置为 1,并根据需要调整 --ntasks 和 --ntasks-per-node。
提交和查看作业
提交作业:
bash
sbatch openmpitest.slurm命令会返回作业 ID,例如:
text
Submitted batch job 280135查看作业状态:
bash
squeue -j 280135也可以查看本人全部作业:
bash
squeue -u "$USER"作业完成后,查看标准输出:
bash
cat openmpitest-280135.out正常输出类似:
text
MPI processes: 4, OpenMP threads/process: 8
Approximation of pi: 3.1415926535898操作录屏示例:
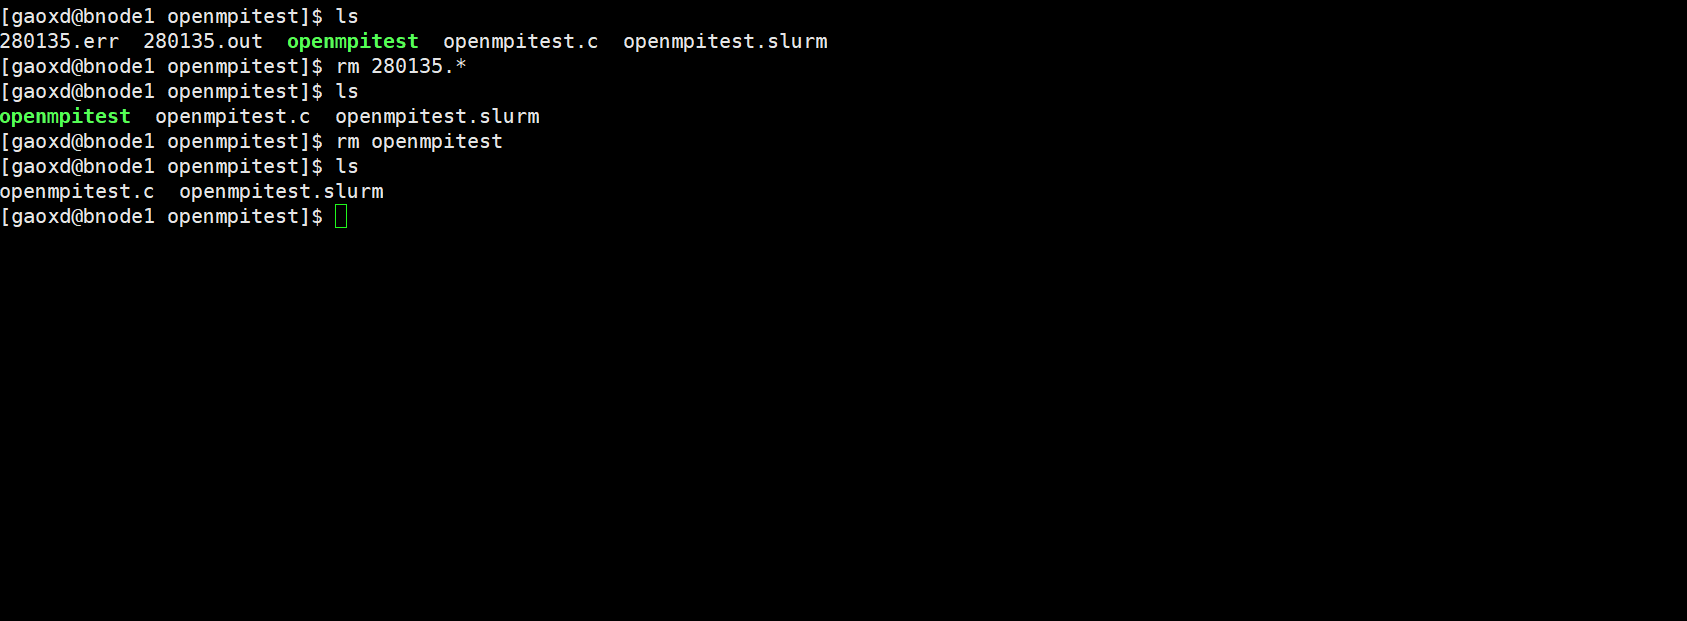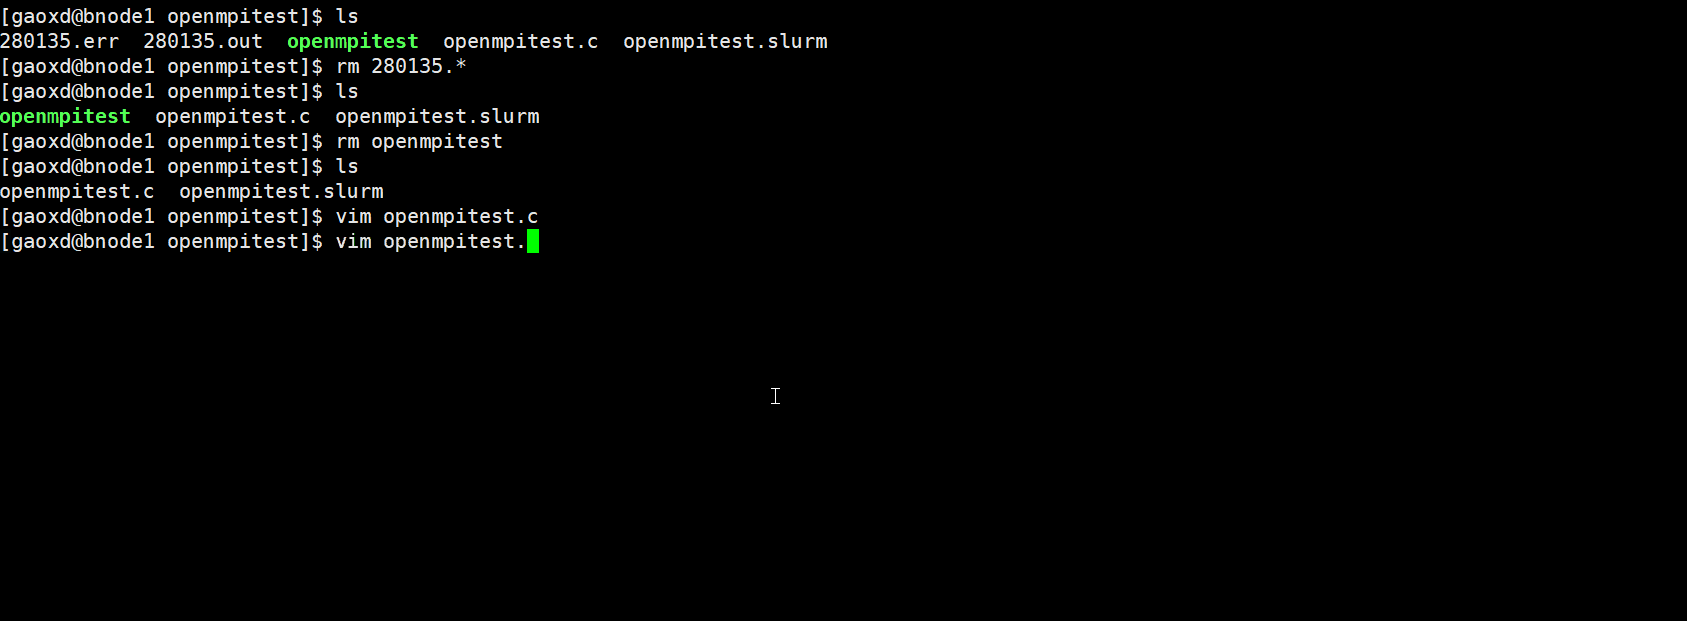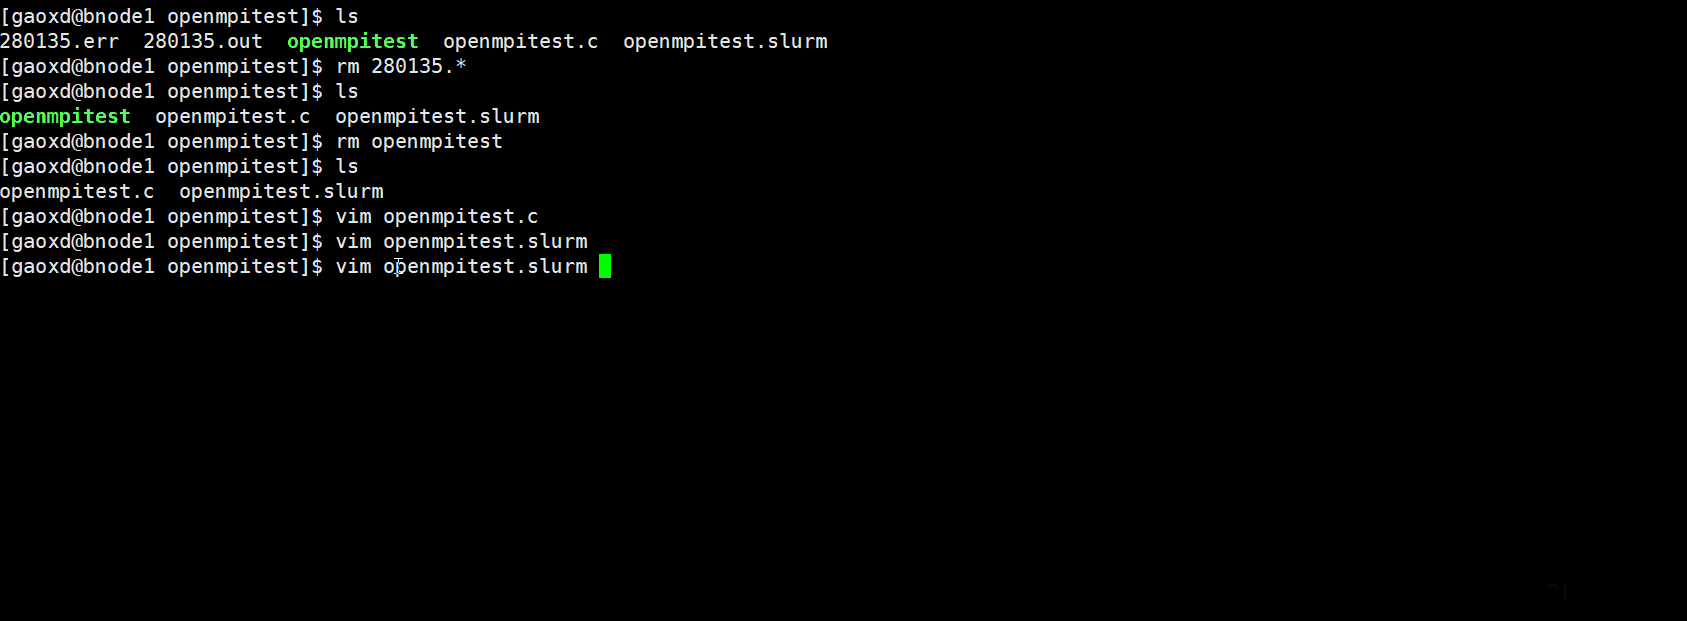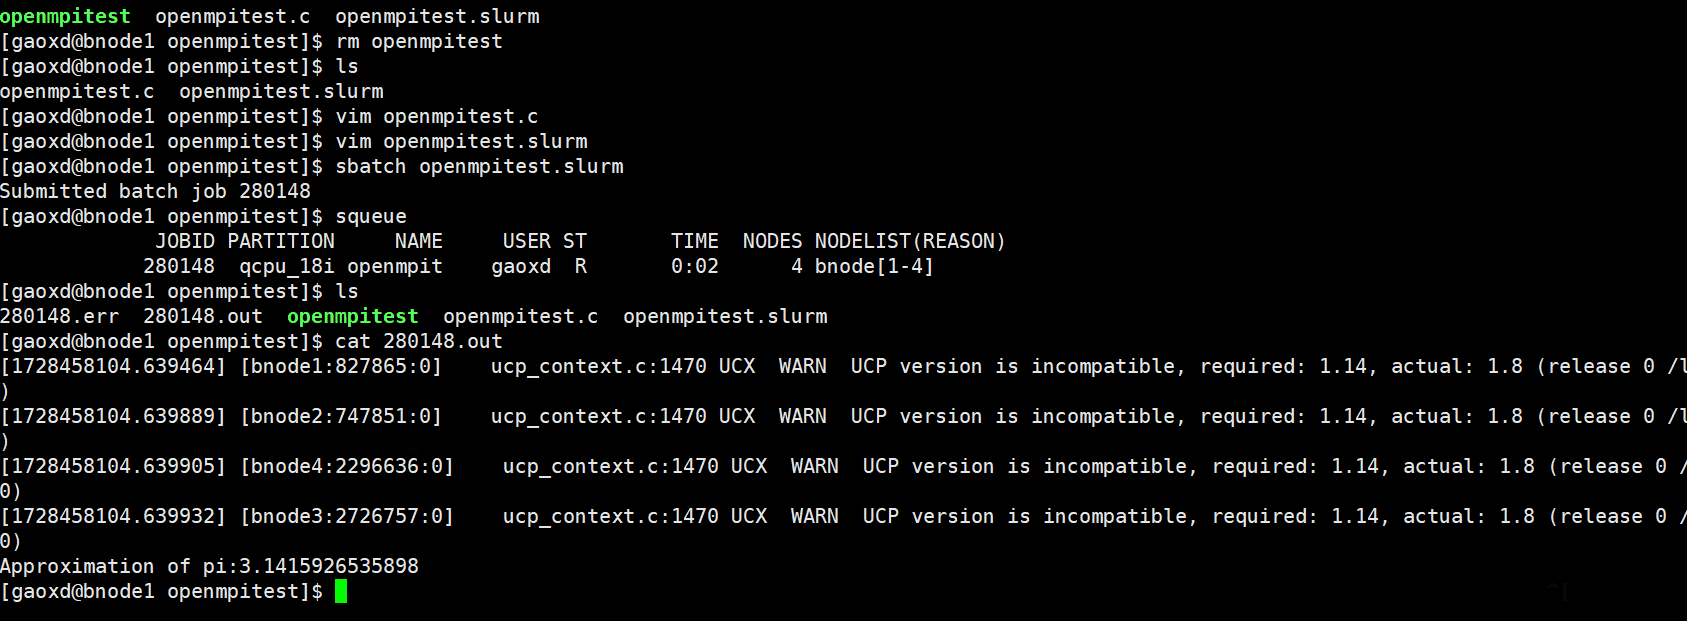
常用检查命令
加载模块后,可以确认编译器和运行环境:
bash
module list
which mpicc
which mpirun
mpicc --version
mpirun --version查看作业实际分配到的节点:
bash
scontrol show job 280135查看作业资源使用情况:
bash
sacct -j 280135 --format=JobID,State,Elapsed,AllocCPUS,MaxRSS,ExitCode常见问题
提示 mpicc: command not found
确认已经加载 GCC 和 OpenMPI 模块。可以先运行 module avail mpi 查看当前可用版本;如果平台上的模块版本发生变化,请将脚本中的模块名称替换为实际可用版本。
作业报错或没有生成输出
先检查错误日志:
bash
cat openmpitest-作业号.err同时确认源码和作业脚本位于同一目录,并且 mpicc 编译阶段没有报错。
MPI 进程数与申请资源不一致
不要在脚本中写入超过 --ntasks 的 mpirun -np 数值。本示例使用 ${SLURM_NTASKS},可让运行进程数自动匹配 Slurm 分配值。
OpenMP 线程过多
确保 OMP_NUM_THREADS 不超过 SLURM_CPUS_PER_TASK。线程数超出申请量会造成 CPU 超配,通常会降低性能,并影响同一节点上的其他作业。
多节点作业无法启动
确认使用的是支持多节点调度的计算队列,并检查错误日志中的网络或 MPI 初始化信息。如果自行编译了其他 OpenMPI 版本,还需要保证编译和运行时使用的是同一套 MPI 环境。